”Er data, vårt uppdrag – Bygg framtiden med våra databaser”
Koncept att integrera & utveckla
Vad innebär SQL Union?
SQL UNION används för att kombinera resultatet från två eller flera SELECT‑frågor till en enda sammanhängande resultatmängd. När UNION körs jämför databasen kolumnerna i varje SELECT‑sats och slår ihop raderna vertikalt, som om du staplade två listor ovanpå varandra. För att UNION ska fungera måste varje SELECT returnera samma antal kolumner och kompatibla datatyper i motsvarande positioner. UNION tar dessutom bort dubbletter som standard, vilket innebär att identiska rader bara visas en gång i resultatet. Om du vill behålla dubbletter används istället UNION ALL. UNION är särskilt användbart när data är spridd över flera tabeller eller vyer men representerar liknande typer av information, exempelvis kunder från olika regioner eller loggar från olika system. Genom att kombinera dessa resultat kan man skapa en mer komplett bild av datat utan att behöva bygga komplexa JOIN‑strukturer. UNION är därför ett effektivt verktyg för att sammanföra likartad information och skapa tydliga, konsoliderade dataset som är enklare att analysera och arbeta vidare med.
Även om UNION i sig bara har två formella varianter, används det i flera praktiska kontexttyper som fungerar som ”olika sorters UNION‑användning”.
SQL UNION tillhör klassen DQL Data Query Language, som är en del av den större gruppen DML Data Manipulation Language. Det betyder att UNION är ett frågeverktyg som används för att hämta och kombinera data, inte för att skapa, ändra eller ta bort strukturer i databasen. UNION påverkar alltså inte tabellerna i sig, utan styr hur data returneras från SELECT‑frågor.
Typer
- UNION – den dubblettrensande varianten: Den vanligaste formen av UNION kombinerar två eller flera SELECT‑frågor och tar bort alla dubbletter i resultatet. Det innebär att om två datakällor innehåller identiska rader visas dessa bara en gång. Den här varianten används när man vill skapa en ren och konsoliderad lista där varje rad representerar unik information, exempelvis när man sammanställer kundlistor från olika regioner och vill undvika överlapp.
- UNION ALL – den fullständiga sammanslagningen: UNION ALL fungerar på samma sätt som UNION men behåller alla rader, även om de är identiska. Det gör den snabbare och mer effektiv när man arbetar med stora datamängder eller när dubbletter är relevanta för analysen. UNION ALL används ofta i logg‑ och transaktionsdata där varje förekomst är viktig, eller när man vill kunna se volymen från olika datakällor utan att filtrera bort något.
- UNION mellan tabeller med samma struktur: En vanlig typ av UNION‑användning är när flera tabeller representerar samma typ av information, exempelvis årsvisa arkiv, geografiska uppdelningar eller historiska versioner. UNION används då för att skapa en sammanhängande vy över all data, vilket gör det enklare att analysera helheten utan att behöva arbeta med separata tabeller.
- UNION med olika filtreringslogik: I många fall kombineras SELECT‑frågor som filtrerar på olika sätt. Det kan handla om att hämta data från olika segment, kategorier eller villkor och slå ihop dem till en gemensam lista. Den här typen av UNION används när man vill samla flera logiska urval i ett enda resultat, exempelvis olika typer av kunder, produkter eller händelser.
- UNION för att märka datakällor: En praktisk användning är att lägga till en etikett eller kategori i varje SELECT‑fråga innan UNION utförs. På så sätt kan man se var varje rad kommer ifrån när resultatet kombineras. Det är vanligt i rapportering där man vill kunna jämföra datakällor i samma resultatmängd, exempelvis olika regioner, system eller tidsperioder.
- UNION mellan tabeller och vyer: UNION används ofta för att kombinera data från både tabeller och vyer. Det gör det möjligt att sammanföra realtidsdata med historiska arkiv, eller att kombinera förprocessad information från en vy med rådata från en tabell. Den här typen av UNION skapar flexibla och kraftfulla datamängder som kan användas för analys, rapportering och kvalitetssäkring.
- UNION som fallback‑mekanism: I vissa system används UNION för att säkerställa att data alltid returneras, även om primära källor saknar information. Genom att kombinera en huvudkälla med en backup‑källa kan man skapa robusta frågor som fungerar även vid driftstörningar eller ofullständig data.
- UNION med sortering i slutet: Även om det inte är en egen variant, är det en särskild typ av användning där sortering läggs på den kombinerade resultatmängden. Det innebär att du först slår ihop datan och sedan styr hur den ska presenteras. Det används när du vill skapa en sammanhängande och ordnad lista från flera datakällor.
Fördelar
- Konsoliderad och sammanhängande datamängd: UNION gör det möjligt att slå samman resultat från flera SELECT‑frågor till en enda helhet. Det ger en tydlig och sammanhängande vy över data som annars ligger utspridd i olika tabeller, vyer eller segment.
- Automatisk borttagning av dubbletter: En central fördel är att UNION automatiskt rensar bort identiska rader. Det leder till renare resultat där varje rad representerar unik information, vilket är särskilt värdefullt i rapporter och sammanställningar.
- Minskad komplexitet jämfört med JOIN: UNION kan ersätta mer avancerade JOIN‑strukturer när målet är att kombinera likartad information snarare än att koppla ihop tabeller via relationer. Det gör frågorna enklare att skriva, läsa och underhålla.
- Flexibilitet i filtrering och logik: Du kan kombinera SELECT‑frågor med olika villkor och filtreringar. Det gör UNION till ett kraftfullt verktyg när du vill samla flera logiska urval i ett enda resultat, exempelvis olika kundtyper, produktkategorier eller tidsperioder.
- Möjlighet att kombinera tabeller och vyer: UNION fungerar lika bra mellan tabeller och vyer, vilket gör det enkelt att kombinera realtidsdata med historiska arkiv eller förprocessad information. Det skapar flexibla datamängder som är användbara i analys och rapportering.
- Stöd för robusta fallback‑lösningar: Genom att kombinera primära och sekundära datakällor kan UNION användas som en fallback‑mekanism. Det säkerställer att data returneras även om en av källorna saknar information.
- Renare kod och bättre prestanda vid dubblettkontroll: Eftersom databasen själv hanterar borttagning av dubbletter slipper du bygga logik i applikationslagret. Det leder till tydligare kod och kan förbättra prestandan i system där dubblettkontroll annars är kostsam.
Nackdelar
- Risk för onödig dubbletthantering: Eftersom UNION automatiskt tar bort dubbletter måste databasen jämföra varje rad mellan alla SELECT‑frågor. Detta kan bli resurskrävande, särskilt vid stora datamängder. Om dubbletter inte är ett problem kan UNION därför vara onödigt tungt jämfört med UNION ALL.
- Krav på identisk struktur mellan SELECT‑frågor: UNION kräver att alla SELECT‑satser returnerar samma antal kolumner och kompatibla datatyper. Det gör UNION mindre flexibelt än JOIN, eftersom du inte kan kombinera tabeller med olika strukturer utan att först anpassa frågorna.
- Kan dölja viktiga dubbletter: Eftersom UNION tar bort identiska rader kan värdefull information försvinna. I loggar, transaktioner eller analyser där varje förekomst är viktig kan UNION ge en missvisande bild av datamängden.
- Prestandaproblem vid stora dataset: När UNION används på stora tabeller eller komplexa SELECT‑frågor kan prestandan påverkas negativt. Dubblettkontrollen kräver sortering och jämförelse, vilket kan leda till långsammare svarstider.
- Mindre kontroll över datakombinationen: UNION kombinerar resultat vertikalt utan att ta hänsyn till relationer mellan tabeller. Det innebär att du inte kan koppla ihop data baserat på nycklar eller logiska samband, vilket gör UNION mindre användbart när du behöver strukturerade relationer.
- Kan leda till svåröverskådliga resultat: När många SELECT‑frågor kombineras kan resultatet bli svårt att tolka, särskilt om datan kommer från olika källor utan tydliga etiketter. Det kan kräva extra arbete för att förstå var varje rad kommer ifrån.
- Begränsningar i sortering och presentation: ORDER BY kan endast användas efter den sista SELECT‑satsen, vilket begränsar möjligheten att sortera delmängder innan de kombineras. Det kan göra det svårare att styra resultatets struktur på ett detaljerat sätt.
Steg-för-steg guide
- Identifiera vad du vill kombinera: Bestäm vilka tabeller eller vyer som innehåller liknande data du vill slå ihop, till exempel kunder från olika regioner eller aktiva och arkiverade poster.
- Säkerställ kompatibel struktur: Kontrollera att varje SELECT‑fråga returnerar samma antal kolumner. Kolumner i samma ordning. Kompatibla datatyper i motsvarande kolumner. Annars kommer UNION att ge fel eller oväntade resultat.
- Formulera första SELECT‑frågan: Skriv en SELECT‑sats som hämtar de kolumner man vill ha från den första tabellen eller vyn. Tänk på att bara ta med de kolumner som ska ingå i unionen.
- Formulera andra (och fler) SELECT‑frågor: Skriv motsvarande SELECT‑satser för de andra tabellerna eller vyerna, med samma kolumnuppsättning och ordning. Varje SELECT körs separat och deras resultat staplas på varandra.
- Koppla ihop frågorna med UNION: Placera UNION mellan SELECT‑satserna för att kombinera resultaten. Använd UNION om man vill ta bort dubbletter. Använd UNION ALL om man vill behålla alla rader, även dubbletter, och ofta få bättre prestanda.
- Lägg till sortering och filtrering (valfritt): Om man vill sortera eller filtrera den sammanslagna resultatmängden använder man WHERE och ORDER BY efter den sista SELECT‑satsen. ORDER BY påverkar hela union‑resultatet, inte varje del för sig.
- Testa och verifiera resultatet: Kör frågan, kontrollera att rätt rader är med. Dubbletter hanteras som man tänkt (UNION vs UNION ALL). Datatyper och kolumnnamn ser rimliga ut. Justera sedan SELECT‑satser, filtrering eller union‑typ tills resultatet matchar din avsikt.
Behöver ni hjälp att komma igång med konceptet?
Vi erbjuder uppdragsbemanning ex software developer, en programerare som en resurs vid genomförandet eller projektledare för bästa styrning. För att få en attraktiv och bra design, ta då in en grafisk designer som hjälp.
Intresserad?
Rekrytering | Bemanning | Utbildning
mikael@hybridwork.se
”Uppmuntra till inlärning med Green Card certifiering och säkerställ att kompetensen finns för att utföra jobbet eller konceptet – ett win-win för både företaget och för era anställda i deras karriär”
Bygger på en kompetensmatris som visar vilka aktiviteter som ska vara uppfyllda med dess status visualiserat.
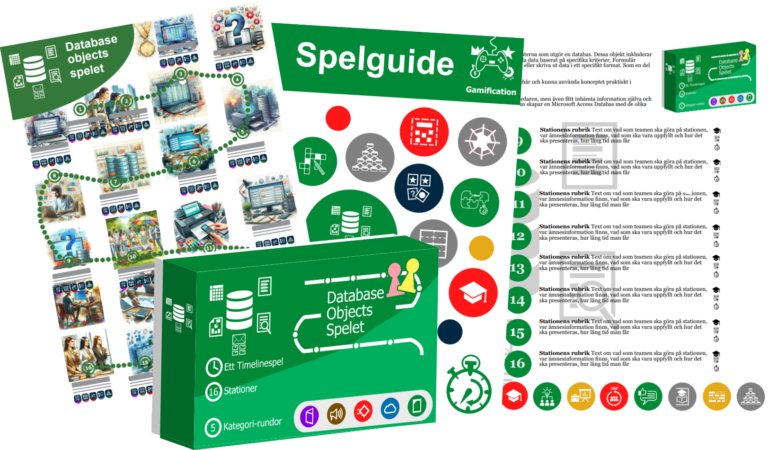
”Timelinespel, ett Gamification event. SQL Union Företagsspel för lättsamt lärande att implementera koncept. Främjar teambuilding och framdrift”
Ett spelupplägg att kunna återkomma till för nya utmaningar. Teamen tränas i att aktivt lära sig och presentera lösningar. Skapar tävlingsmoment.
”IT stödet IKM Manager är programmoduler skräddarsytt direkt för SQL Union konceptet och stödjer ett standardiserat arbetssätt. Ger samtidigt både framdrift och historik.”
Går att företagsanpassa och vara kopplat mot affärssystem eller visualiseringsprogram ex Power Bi. Har en användarmanual som även visar hur programmet är uppbyggt.
”Ge rätt förutsättning vid införandet av SQL Union konceptet med en projektplan som har tidsatta aktiviteter och en projektbudget”
Vem gör vad och när? Skapar framdrift. Göra konceptets aktiviteter i rätt tid för att kunna vara klar enligt planerat. Vi hjälper gärna er som extern projektledare.