”Er data, vårt uppdrag – Bygg framtiden med våra databaser”
Koncept att integrera & utveckla
Vad innebär SQL State?
SQL State är en standardiserad femteckenskod som används av databashanterare för att beskriva typen av fel eller varning som uppstått vid körning av en SQL‑fråga. Koden är en del av SQL‑standardens felhanteringssystem och gör det möjligt att förstå vilken kategori ett fel tillhör, oberoende av vilken databasplattform som används. De två första tecknen anger felklass, medan de tre sista specificerar den exakta underkategorin. Genom att använda SQL State kan utvecklare och administratörer snabbt identifiera om problemet handlar om exempelvis syntaxfel, anslutningsproblem, integritetsbrott eller otillåtna operationer. Detta skapar en enhetlig och förutsägbar struktur för felsökning, vilket är särskilt värdefullt i miljöer där flera databaser eller applikationer samverkar. SQL State bidrar därmed till tydligare loggar, snabbare analys och mer robust felhantering i både små och stora system.
SQL State tillhör gruppen SQL/PSM – fel- och undantagshantering inom SQL‑standarden. Det är alltså inte en DDL‑, DML‑ eller DCL‑funktion, utan en del av den procedurala och diagnostiska delen av SQL‑standarden, som används för att beskriva fel, varningar och statuskoder på ett enhetligt sätt.
SQL State är en diagnostisk mekanism som används av databasmotorer för att rapportera fel, varningar, transaktionsproblem, anslutningsproblem, dataintegritetsbrott. Det är därför en del av SQL/PSM (Persistent Stored Modules) och SQL Diagnostics, som hanterar exceptions, conditions, felklasser, felkoder, signalering av fel i procedurer och funktioner. SQL State är alltså inte en operation på data, utan ett system för felrapportering som ligger utanför de klassiska SQL‑grupperna.
Typer
- Klass 00 – Successful Completion: Denna klass betyder att kommandot lyckades utan fel. Exempel 00000 – Allt gick bra.
- Klass 01 – Warning: Operationen lyckades, men något avvikande inträffade. Exempel 01000 – Allmän varning. 01003 – Null‑värde eliminerat i en aggregering. 01007 – Privilegier inte beviljade.
- Klass 02 – No Data: Används ofta vid FETCH eller SELECT när inga rader returneras. Exempel 02000 – Ingen data hittades.
- Klass 07 – Dynamic SQL Error: Fel kopplade till dynamiska SQL‑operationer. Exempel 07001 – Parameter saknas. 07002 – För många parametrar.
- Klass 08 – Connection Exception: Fel relaterade till databasanslutning. Exempel 08001 – Kan inte ansluta. 08003 – Anslutning inte etablerad. 08006 – Anslutning misslyckades.
- Klass 21 – Cardinality Violation: Resultatet innehåller fler eller färre rader än förväntat. Exempel 21000 – Cardinality violation.
- Klass 22 – Data Exception: Fel kopplade till datatyper, format eller värden. Exempel 22001 – Strängdata för lång. 22003 – Numeriskt värde utanför intervall. 22007 – Ogiltigt datumformat. 22012 – Division med noll.
- Klass 23 – Integrity Constraint Violation: Fel kopplade till constraints. Exempel 23000 – Constraint violation. 23505 – Duplicate key (vanlig i PostgreSQL).
- Klass 24 – Invalid Cursor State: Fel kopplade till cursorhantering. Exempel 24000 – Invalid cursor state.
- Klass 25 – Invalid Transaction State: Fel relaterade till transaktioner. Exempel 25000 – Invalid transaction state.
- Klass 28 – Invalid Authorization Specification: Fel kopplade till autentisering. Exempel 28000 – Ogiltiga inloggningsuppgifter.
- Klass 40 – Transaction Rollback: Transaktionen avbröts. Exempel 40001 – Serialization failure. 40003 – Statement completion unknown.
- Klass 42 – Syntax Error or Access Rule Violation: Den vanligaste felklassen vid SQL‑utveckling. Exempel 42000 – Syntaxfel. 42P01 – Tabell saknas (PostgreSQL). 42S02 – Tabell saknas (MySQL/ODBC).
- Klass HV – Foreign Data Wrapper Errors (PostgreSQL): Används vid externa datakällor. Exempel HV000 – FDW‑fel. HV005 – Ogiltig kolumnnamn.
- Klass XX – Internal Error: Allvarliga interna fel i databasmotorn. Exempel XX000 – Internal error.
Fördelar
- Standardiserade felkoder (ISO‑standard): SQL STATE bygger på en internationell standard, vilket innebär att samma kod betyder samma sak oavsett databasplattform. Det skapar en stabil och förutsägbar grund för felsökning och systemdesign, eftersom du inte behöver tolka olika formuleringar eller databasspecifika meddelanden. När organisationer arbetar tvärfunktionellt eller bygger lösningar som ska fungera i flera miljöer blir denna standardisering en tydlig kvalitetsfördel.
- Mer exakt felsökning: Eftersom SQL STATE alltid består av fem tecken och är uppdelad i en klass och en subklass ger den en tydlig struktur som gör det lättare att förstå både typ och orsak till felet. Denna precision gör att du snabbare kan identifiera var problemet uppstår och varför, vilket minskar tiden för rotorsaksanalys och förbättrar stabiliteten i dataprocesser och integrationer.
- Bättre felhantering i applikationer: SQL STATE gör det möjligt för applikationer att reagera på specifika felkoder istället för att försöka tolka textbaserade felmeddelanden. Det leder till mer robust logik, särskilt i transaktionstunga system där du behöver kunna hantera deadlocks, återförsök, anslutningsproblem eller datavalideringsfel på ett konsekvent sätt. Resultatet blir en mer förutsägbar och motståndskraftig applikationsarkitektur.
- Förutsägbarhet vid integrationer: När olika system kommunicerar med varandra skapar SQL STATE en gemensam felterminologi som minskar risken för missförstånd. API:er, ETL‑flöden och mikrotjänster kan utbyta felkoder som är lätta att tolka och agera på, vilket gör att integrationskedjor blir mer stabila och enklare att övervaka. Detta är särskilt värdefullt i komplexa datalandskap där många komponenter samverkar.
- Stöd för kvalitetsarbete och Lean‑processer: SQL STATE bidrar till ett mer strukturerat kvalitetsarbete genom att göra det enklare att kategorisera fel, identifiera mönster och bygga Poka‑Yoke‑logik som förhindrar att fel uppstår. Eftersom koderna är konsekventa kan de användas för att skapa standardiserade arbetsmetoder, tydliga felsökningsguider och stabila processer som stödjer kontinuerliga förbättringar och minskar variation i datakvalitet.
- Lättare loggning och övervakning: När felkoder är konsekventa blir loggar mer strukturerade och enklare att analysera. SQL STATE gör det möjligt att bygga dashboards, alerting och incidenthantering som baseras på tydliga felkategorier, vilket ger snabbare insikt och bättre kontroll över systemens hälsa. Det blir också enklare att följa trender och identifiera återkommande problem.
- Mindre beroende av språk och formuleringar: Eftersom SQL STATE är språkoberoende slipper du variationer i felmeddelanden som beror på översättningar, versioner eller leverantörsspecifika uttryck. Det gör system mer framtidssäkra och minskar risken för att logik bryts när textmeddelanden förändras. Felhantering blir därmed mer stabil och mindre känslig för förändringar i omgivande system.
- Underlättar utbildning och dokumentation: En fast och tydlig uppsättning felkoder gör det enklare att skapa utbildningsmaterial, checklistor, felsökningsguider och rollbaserade instruktioner. SQL STATE blir ett gemensamt språk som både utvecklare, analytiker, drift och QA kan använda, vilket stärker tvärfunktionellt samarbete och gör onboarding snabbare och mer effektiv.
Nackdelar
- Begränsad detaljnivå i vissa databaser: Även om SQL STATE är standardiserat använder olika databasmotorer ibland egna utökningar eller avvikelser. Det innebär att vissa felkoder kan vara mindre detaljerade eller inte fullt konsekventa mellan plattformar. Resultatet blir att utvecklare ibland måste kombinera SQL STATE med databasspecifika felmeddelanden för att få en komplett bild av problemet, vilket kan minska den enhetlighet som standarden försöker skapa.
- Kan vara svårtolkat för nybörjare: Eftersom SQL STATE består av kodstrukturer snarare än beskrivande text kräver det en viss vana att tolka dem korrekt. För personer som är nya inom databasutveckling eller felsökning kan koderna upplevas abstrakta och svåra att koppla till verkliga problem. Detta kan förlänga inlärningskurvan och skapa beroende av dokumentation eller mer erfarna kollegor.
- Variationer mellan databasmotorer: Trots standarden implementerar olika databaser SQL STATE på lite olika sätt. Vissa använder fler egna subkoder, andra återanvänder generella koder för flera typer av fel. Detta leder till att samma typ av fel kan uttryckas olika beroende på plattform, vilket försvårar portabilitet och tvärfunktionell felsökning. I praktiken kan det innebära att team måste hantera både standardkoder och leverantörsspecifika avvikelser.
- Kräver kompletterande felinformation: SQL STATE ger en strukturerad klassificering av felet, men ofta behövs mer kontext för att förstå exakt vad som har hänt. Det kan handla om vilken tabell som saknas, vilket värde som är ogiltigt eller vilken constraint som bröts. Eftersom SQL STATE inte alltid innehåller denna detaljinformation måste utvecklare ofta kombinera koden med textmeddelanden eller loggar för att få en fullständig bild, vilket gör felsökningen mer komplex.
- Begränsad användning i vissa verktyg och ramverk: Alla applikationsramverk, drivrutiner eller integrationsverktyg använder inte SQL STATE fullt ut. I vissa fall prioriteras interna felkoder eller undantagstyper, vilket gör att SQL STATE inte alltid är den primära källan för felhantering. Detta kan skapa inkonsekvens i hur fel rapporteras och hanteras i olika delar av ett system, särskilt i miljöer med många tekniska komponenter.
- Kan ge falsk känsla av standardisering: Eftersom SQL STATE är en standard kan det vara lätt att anta att alla databaser följer den strikt. I praktiken finns det betydande skillnader i hur koder implementeras, utökas och dokumenteras. Detta kan leda till att team överskattar graden av kompatibilitet och bygger lösningar som inte fungerar lika bra när de flyttas mellan databasmotorer eller versioner.
Steg-för-steg guide
- Förstå vad SQL STATE är och hur koderna är uppbyggda: SQL STATE är en femteckenskod som beskriver typen av fel (klass) och mer specifik orsak (subklass). De två första tecknen är felklass, de tre sista är subklass. Börja med att läsa dokumentationen för databasmotor (t.ex. PostgreSQL, MySQL, DB2) och identifiera vilka SQL STATE‑koder som är vanligast i dina scenarier, till exempel constraint‑fel, anslutningsfel eller datavalideringsfel. Syftet med detta steg är att skapa en grundläggande förståelse för hur koderna hänger ihop med verkliga fel.
- Kartlägg relevanta SQL STATE‑koder för din miljö: Gör en enkel lista eller tabell över de SQL STATE‑koder som är viktigast för systemet, till exempel unika nyckelkonflikter, foreign key‑fel, deadlocks, ogiltiga datumformat och anslutningsproblem. Koppla varje kod till en kort beskrivning, typ av scenario och önskad åtgärd. Denna kartläggning blir interna “felkatalog” som kan användas av både utvecklare, drift och analytiker.
- Bestäm hur olika feltyper ska hanteras: För varje SQL STATE‑kod eller kodgrupp, definiera vilken reaktion som är rimlig: ska transaktionen rullas tillbaka, ska ett automatiskt återförsök göras, ska användaren få ett tydligt meddelande, eller ska felet bara loggas för vidare analys? Här kan man tänka i Lean‑termer: vilka fel är kritiska för dataintegritet, vilka är förväntade och vilka är signaler om systemproblem? Målet är att skapa en konsekvent felhanteringsstrategi baserad på SQL STATE.
- Implementera SQL STATE‑baserad felhantering i databaskod: I stored procedures, triggers eller SQL‑skript, se till att man kan läsa ut SQL STATE när ett fel uppstår. I många databaser kan man få tag på SQL STATE i exception‑hantering (t.ex. WHEN OTHERS i PL/pgSQL eller motsvarande). Använd koden för att styra logik: om SQL STATE motsvarar ett deadlock kan man till exempel rulla tillbaka och försöka igen, medan ett datavalideringsfel kanske ska leda till ett tydligt felmeddelande till applikationen. Detta steg gör att databasen själv blir mer medveten om feltyperna.
- Använd SQL STATE i applikationslagret: I applikationskoden (t.ex. C#, Java, Python) fångar du databaskopplade undantag och läser ut SQL STATE från felobjektet eller drivrutinen, om den exponerar koden. Bygg sedan logik som reagerar på specifika koder: vissa fel kan trigga retry‑mekanismer, andra kan visa användarvänliga meddelanden, och ytterligare andra kan leda till att en incident skapas. På så sätt blir SQL STATE en gemensam “signal” mellan databasen och applikationen.
- Strukturera loggning och övervakning kring SQL STATE: Se till att SQL STATE alltid loggas tillsammans med tidpunkt, användare/system, transaktion och eventuell kontext (t.ex. tabell, operation). Bygg dashboards eller rapporter där man kan se frekvensen av olika SQL STATE‑koder över tid. Detta gör det möjligt att identifiera återkommande problem, flaskhalsar och kvalitetsbrister, och ger ett bra underlag för rotorsaksanalyser och förbättringsarbete.
- Skapa utbildningsmaterial och riktlinjer baserat på SQL STATE: Ta kartläggning och erfarenheter och omvandla dem till korta guider, checklistor och rollbaserade instruktioner: vad utvecklare ska tänka på, hur drift ska tolka vissa koder, hur QA kan använda SQL STATE i testfall, och hur analytiker kan läsa loggar. Genom att göra SQL STATE till ett gemensamt språk i organisationen blir felhantering mindre personberoende och mer standardiserad.
- Revidera och förbättra regelbundet: När systemet utvecklas, nya fel uppstår och nya integrationer tillkommer, behöver SQL STATE‑strategi uppdateras. Lägg in en rutin där man regelbundet går igenom vilka koder som förekommer, vilka som saknar tydlig hantering och var det finns förbättringspotential. På så sätt blir arbetet med SQL STATE en del av ett levande förbättringssystem snarare än en engångsinsats.
Behöver ni hjälp att komma igång med konceptet?
Vi erbjuder uppdragsbemanning ex software developer, en programerare som en resurs vid genomförandet eller projektledare för bästa styrning. För att få en attraktiv och bra design, ta då in en grafisk designer som hjälp.
Intresserad?
Rekrytering | Bemanning | Utbildning
mikael@hybridwork.se
”Uppmuntra till inlärning med Green Card certifiering och säkerställ att kompetensen finns för att utföra jobbet eller konceptet – ett win-win för både företaget och för era anställda i deras karriär”
Bygger på en kompetensmatris som visar vilka aktiviteter som ska vara uppfyllda med dess status visualiserat.
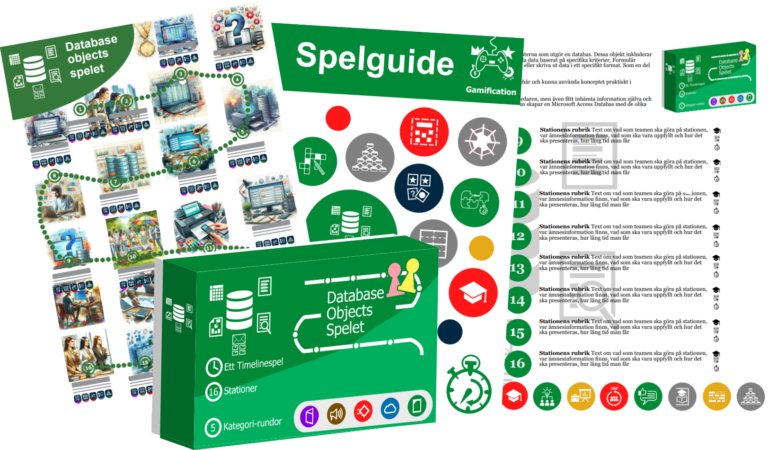
”Timelinespel, ett Gamification event. SQL State Företagsspel för lättsamt lärande att implementera koncept. Främjar teambuilding och framdrift”
Ett spelupplägg att kunna återkomma till för nya utmaningar. Teamen tränas i att aktivt lära sig och presentera lösningar. Skapar tävlingsmoment.
”IT stödet IKM Manager är programmoduler skräddarsytt direkt för konceptet och stödjer ett standardiserat arbetssätt. Ger samtidigt både framdrift och historik.”
Går att företagsanpassa och vara kopplat mot affärssystem eller visualiseringsprogram ex Power Bi. Har en användarmanual som även visar hur programmet är uppbyggt.
”Ge rätt förutsättning vid införandet av SQL State konceptet med en projektplan som har tidsatta aktiviteter och en projektbudget”
Vem gör vad och när? Skapar framdrift. Göra konceptets aktiviteter i rätt tid för att kunna vara klar enligt planerat. Vi hjälper gärna er som extern projektledare.